Моніторинг доступності кількох серверів – це не просто завдання, а наріжний камінь стабільності вашої IT-інфраструктури. Для ефективного відстеження працездатності парку машин існує спектр рішень: від простих хмарних сервісів, які швидко розгортаються і не вимагають глибоких технічних знань, до потужних платформ, що самостійно розгортаються, які надають повний контроль і глибоку кастомізацію, а також кастомних скриптів для специфічних потреб. Вибір відповідного інструменту залежить від масштабу вашої інфраструктури, бюджету, вимог до гнучкості та компетенцій вашої команди. Головна мета – забезпечити своєчасне виявлення проблем і мінімізацію простою, щоб ви могли спати спокійно, знаючи, що ваша система під наглядом.
Чому моніторинг доступності – це не розкіш, а необхідність?
У сучасному світі, де будь-яка затримка або збій можуть обернутися значними репутаційними і фінансовими втратами, надійний моніторинг доступності серверів є критично важливим. Давайте розберемося, чому це так:
- Швидке виявлення проблем: Чим швидше ви дізнаєтеся про збій, тим оперативніше зможете відреагувати. Моніторинг дозволяє перейти від реактивного виправлення до проактивного управління інцидентами.
- Мінімізація простою і фінансових втрат: Кожна година простою веб-сервера, бази даних або іншого критично важливого сервісу може коштувати компанії тисячі, а то й мільйони гривень. Своєчасне сповіщення допомагає скоротити час відновлення.
- Поліпшення користувацького досвіду: Доступність ваших сервісів безпосередньо впливає на задоволеність кінцевих користувачів або клієнтів. Стабільна робота – запорука лояльності.
- Планування ресурсів і масштабування: Хоча моніторинг доступності в першу чергу стосується статусу "живий/мертвий", багато інструментів надають і метрики продуктивності. Аналізуючи їх, можна передбачати потенційні проблеми з ресурсами і планувати масштабування.
- Дотримання SLA: Для багатьох компаній, особливо тих, що працюють за контрактами з клієнтами, дотримання угод про рівень обслуговування (SLA) є обов'язковим. Моніторинг надає дані для підтвердження відповідності цим вимогам.
Основні підходи до моніторингу доступності кількох серверів
Різноманітність інфраструктур і бізнес-потреб призвела до появи кількох ключових підходів до моніторингу. Розглянемо їх докладніше.
1. Готові хмарні сервіси (SaaS-рішення)
Ці сервіси пропонують "моніторинг як послугу", дозволяючи вам швидко налаштувати перевірки без необхідності розгортати власну інфраструктуру. Вони ідеально підходять для стартапів, малого і середнього бізнесу, а також для зовнішнього моніторингу критично важливих веб-сервісів.
Популярні приклади: Pingdom, UptimeRobot, StatusCake, Site24x7, Freshping.
Як це працює?
Ви реєструєтеся на платформі, додаєте IP-адреси або доменні імена ваших серверів, вказуєте порти або URL-адреси для перевірки. Сервіс з певною періодичністю (наприклад, кожні 1-5 хвилин) відправляє запити до ваших серверів з різних географічних точок і при виявленні недоступності відправляє повідомлення.
Переваги:
- Швидкий старт: Налаштування займає лічені хвилини.
- Простота використання: Інтуїтивно зрозумілі інтерфейси, не вимагають глибоких технічних знань.
- Глобальні точки перевірки: Моніторинг здійснюється з різних країн, що дозволяє оцінити доступність для різних регіонів і виявити проблеми з маршрутизацією.
- Мінімум обслуговування: Вся інфраструктура і підтримка на стороні провайдера.
- Різноманітність методів перевірки: ICMP (ping), HTTP/HTTPS (статус коду, вміст сторінки), TCP-порти, DNS, SMTP/POP3/IMAP, FTP.
Недоліки:
- Вартість: Зазвичай залежить від кількості моніторів і інтервалів перевірок, може рости з масштабом.
- Обмежена кастомізація: Ви обмежені функціоналом, що надається сервісом.
- Залежність від провайдера: Доступність вашої системи моніторингу залежить від доступності хмарного сервісу.
Приклад налаштування HTTP-моніторингу в UptimeRobot:
Тип: HTTP(s)
URL: https://ваш-сервер.ru/health
Інтервал: 1 хвилина
Таймаут: 30 секунд
Ключове слово: "OK" (необов'язково, для перевірки вмісту сторінки)
2. Платформи, що самостійно розгортаються (Self-Hosted)
Якщо вам потрібен повний контроль, глибока інтеграція і максимальна гнучкість, то самостійне розгортання платформи моніторингу – ваш вибір. Це вимагає більше зусиль на старті, але окупається в довгостроковій перспективі для великих і складних інфраструктур.
Популярні приклади: Zabbix, Nagios (і його форки, такі як Icinga), Prometheus + Grafana.
Zabbix
Потужна і гнучка платформа, що підтримує як агентний, так і безагентний моніторинг. Дозволяє збирати тисячі метрик з серверів, мережевого обладнання, додатків і баз даних. Володіє розвиненою системою тригерів, шаблонів і візуалізації.
- Плюси: Вкрай гнучкий, масштабований, велика спільнота, багатий функціонал сповіщень і візуалізації.
- Мінуси: Досить складний в освоєнні і первісному налаштуванні, вимагає значних ресурсів для великих інсталяцій.
Приклад перевірки доступності порту 22 (SSH) через Zabbix Agent (UserParameter):
UserParameter=ssh.port.check,nc -z -w 1 localhost 22 &>/dev/null; echo $?Цей параметр можна додати в конфігурацію агента Zabbix, після чого на сервері Zabbix створити елемент даних, який буде опитувати цей UserParameter і тригер, що спрацьовує, якщо значення буде дорівнює 1 (порт недоступний).
Nagios / Icinga
Одні з найстаріших і перевірених часом систем моніторингу. Nagios Core послужив основою для безлічі інших проектів, включно з Icinga, яка активно розвивається і пропонує більш сучасний інтерфейс і функціонал. Вони використовують плагіни для перевірок, що робить їх дуже розширюваними.
- Плюси: Стабільність, величезна кількість готових плагінів, надійність.
- Мінуси: Інтерфейс може здатися застарілим (особливо у Nagios Core), конфігурація в текстових файлах може бути складною для великих систем.
Prometheus + Grafana
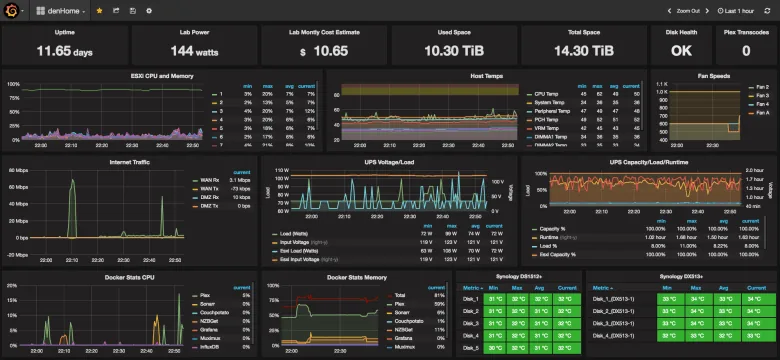
Prometheus – це система моніторингу з відкритим вихідним кодом, орієнтована на метрики. Вона використовує pull-модель (Prometheus сам забирає метрики з цільових систем) і ідеально підходить для динамічних середовищ, таких як контейнери і мікросервіси. У парі з Grafana (потужним інструментом для візуалізації даних) створює дуже ефективну і сучасну систему моніторингу.
- Плюси: Відмінно підходить для метричного моніторингу, потужна мова запитів (PromQL), висока масштабованість, чудова візуалізація з Grafana.
- Мінуси: Не є повноцінним рішенням для логування або розподіленого трасування, вимагає освоєння специфічного підходу.
3. Хмарні платформи моніторингу (Cloud-Native)
Якщо ваша інфраструктура повністю або переважно розгорнута в публічній хмарі (AWS, Azure, Google Cloud), то використання нативних інструментів моніторингу може бути найбільш ефективним.
Приклади: AWS CloudWatch, Azure Monitor, Google Cloud Monitoring.
Переваги:
- Глибока інтеграція: Автоматичне виявлення ресурсів, збір метрик "з коробки" для всіх хмарних сервісів.
- Масштабованість: Розроблено для роботи з динамічними і великими хмарними середовищами.
- Єдина панель управління: Централізований моніторинг всієї хмарної інфраструктури.
Недоліки:
- Прив'язка до конкретної хмари: Менш зручні для гібридних або мультихмарних середовищ.
- Вартість: Може швидко рости в залежності від обсягу даних, що збираються, і кількості сповіщень.
4. Скриптовий моніторинг (Custom Scripts)
Для дуже специфічних завдань, швидких перевірок або інтеграції з унікальними системами, написання власних скриптів залишається актуальним і потужним інструментом. Це дозволяє контролювати кожен аспект перевірки.
Коли використовувати:
- Перевірка доступності специфічного внутрішнього API.
- Моніторинг дуже рідкісних або унікальних станів.
- Легковагі перевірки на невеликій кількості серверів.
- Інтеграція з наявними внутрішніми системами оповіщення.
Мови: Bash, Python, Perl, PowerShell.
Як це працює?
Ви пишете скрипт, який виконує потрібну перевірку (наприклад, намагається підключитися до порту, робить HTTP-запит, перевіряє наявність процесу). Скрипт повертає код успіху/помилки або виводить повідомлення. Потім ви налаштовуєте його запуск за розкладом (наприклад, через cron в Linux або Task Scheduler у Windows) і обробляєте результат, відправляючи повідомлення за потреби.
Простий Bash-скрипт для перевірки доступності HTTP:
#!/bin/bash
# Скрипт для перевірки доступності HTTP-сервісу і логування
URL="https://ваш-сервер.ru/health"
LOG_FILE="/var/log/http_monitor.log"
ALERT_EMAIL="[email protected]"Цей скрипт можна запускати кожні 5 хвилин через cron. Він буде записувати статус в лог-файл і відправляти лист, якщо сервер недоступний.
Порівняння підходів: SaaS vs. Self-Hosted
Для наочності зведемо ключові відмінності в таблицю, щоб допомогти вам зробити інформований вибір.
| Критерій | SaaS-рішення (Pingdom, UptimeRobot) | Self-Hosted платформи (Zabbix, Prometheus) |
|---|---|---|
| Швидкість запуску | Дуже висока (години) | Низька/Середня (дні/тижні) |
| Складність налаштування | Низька (через веб-інтерфейс) | Висока (встановлення, конфігурація агентів, бази даних) |
| Гнучкість/Кастомізація | Обмежена (рамками сервісу) | Висока (повний контроль над логікою та даними) |
| Вартість | Абонентська плата (зростає з масштабом) | Витрати на інфраструктуру та обслуговування (персонал) |
| Масштабованість | Автоматична (на стороні провайдера) | Потребує планування, ресурсів та зусиль команди |
| Контроль даних | Обмежений (дані зберігаються у провайдера) | Повний контроль (дані на вашій інфраструктурі) |
| Вимоги до адмінів | Мінімальні (управління через UI) | Значні (встановлення, налаштування, підтримка, усунення проблем) |
dnsСервер під цю інструкцію
Відповідні тарифи перевірених провайдерів, ціни оновлюються щодня.



Порівняти:Vultr vs DigitalOceanVultr vs ContaboVPS за криптовалютуУсі VPS за ціною
Партнерські посилання: за покупку ми можемо отримати комісію, ціна для вас не змінюється.
Найкращі практики моніторингу доступності
Незалежно від обраного інструменту, є загальні принципи, які допоможуть вам побудувати ефективну систему моніторингу:
- Моніторинг ззовні та зсередини: Використовуйте SaaS-рішення для зовнішнього моніторингу (як бачать користувачі) та Self-Hosted/скрипти для внутрішнього (стан служб, ресурсів).
- Гранулярність та інтервали: Не перевантажуйте систему моніторингу занадто частими перевірками, але й не робіть їх занадто рідкісними. Оптимально – 1-5 хвилин для критичних сервісів.
- Порогові значення та тригери: Не просто "up/down". Налаштовуйте тригери на основі порогових значень (наприклад, "час відповіді більше 500 мс протягом 3 хвилин").
- Система оповіщень:
- Уникайте "alert fatigue": Налаштуйте повідомлення так, щоб вони були значущими. Не повідомляйте про кожну дрібницю, фокусуйтесь на тому, що вимагає негайної уваги.
- Ескалація: Налаштуйте рівні оповіщень. Спочатку email, потім SMS/месенджер, потім дзвінок (наприклад, через PagerDuty або Opsgenie) для найбільш критичних випадків.
- Інтегруйте з вашими робочими інструментами: Slack, Telegram, Microsoft Teams – чим швидше команда побачить оповіщення, тим краще.
"Хороший моніторинг — це той, який будить тебе тільки по справі, але будить завжди."
- Документування: Що моніториться, чому, які дії вживати при спрацюванні оповіщення. Це безцінно для нових співробітників або при роботі в умовах стресу.
- Регулярний аудит: Періодично переглядайте свою систему моніторингу. Чи актуальні всі перевірки? Чи немає "мертвих" моніторів?
- Проактивність: Використовуйте моніторинг не тільки для реакції на інциденти, але й для аналізу трендів. Зростання часу відповіді або зменшення вільного місця можуть бути провісниками майбутніх проблем.
Висновки
Моніторинг доступності декількох серверів – це не одноразове налаштування, а безперервний процес, що вимагає уваги та адаптації. Це інвестиція в стабільність та надійність вашої IT-інфраструктури, яка окупається спокоєм вашої команди та лояльністю ваших користувачів.
Вибір відповідного інструменту або комбінації інструментів залежить від безлічі факторів: розміру вашої інфраструктури, бюджету, вимог до гнучкості та глибини контролю, а також від компетенцій вашої команди. Почніть з простого, будь то хмарний сервіс або декілька скриптів, і поступово масштабуйте та ускладнюйте систему по мірі зростання ваших потреб.
Пам'ятайте, що найкращий моніторинг – це той, який працює для вас, своєчасно інформує про реальні проблеми та дозволяє зосередитися на розвитку, а не на гасінні пожеж.